예측에서 증명까지: CMC 화학 공정을 위한 하나의 플랫폼
제형 연구원에게 이미 결과를 짐작하고 있던 실험을 다시 도는 데 한 주 중 얼마를 쓰는지 물으면, 답은 좀처럼 작지 않습니다.
그 짐작이 애초에 어디서 나왔는지 물으면, 솔직한 답은 대개 이렇습니다. PDF 폴더, 특허 더미, 그리고 2년 전 다른 프로젝트를 위해 누군가 만들어둔 엑셀 파일.
분자의 물성을 예측하는 것만으로 이 문제가 해결된다면 편했을 것입니다. 하지만 그렇지 않습니다. 물성 추정값은 그것이 어딘가로 이어질 때만 쓸모가 있습니다. 제형 후보로, 실험 계획으로, 기준과 비교해 확인할 수 있는 결과로 말입니다. 예측을 완제품처럼 취급하면, 결국 대체하려던 엑셀 옆에 계산기 하나를 더 놓는 셈이 됩니다.
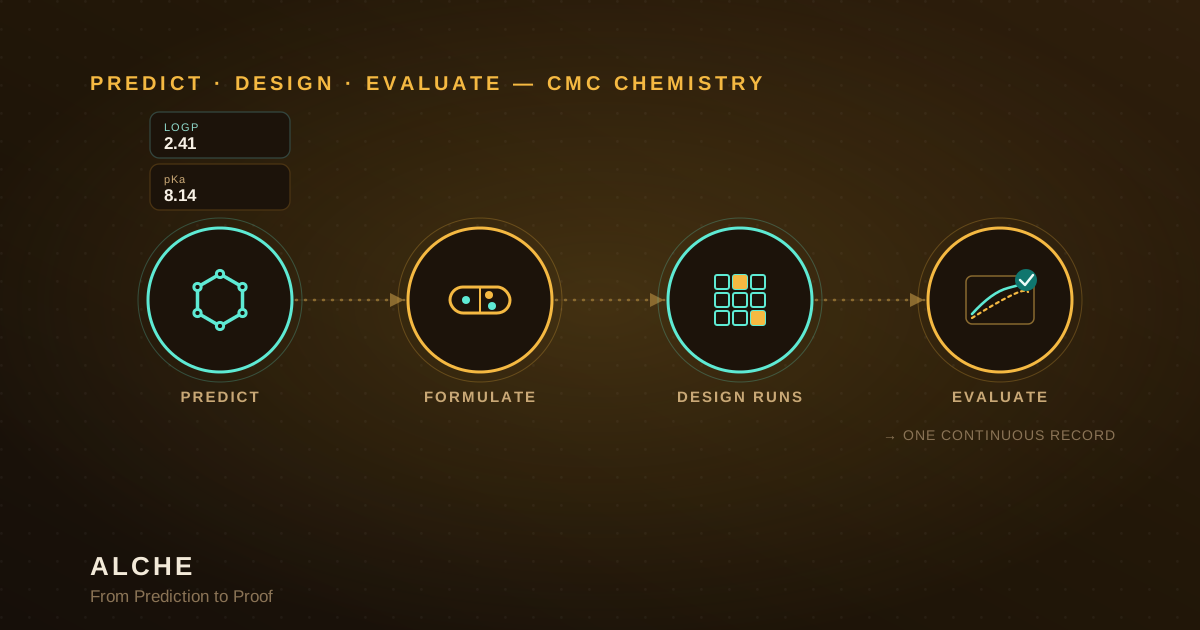
알케는 CMC — Chemistry, Manufacturing, and Controls 중 화학(C)에 해당하는 작업을 위한 플랫폼을 만들었습니다. 물성 예측에서 시작하지만 거기서 끝나지 않습니다. 예측된 물성에서 출발해 제형 설계와 실험 계획을 거쳐, 보고하고 재사용할 수 있는 결과까지 화합물 하나를 끝까지 데려갑니다.
SMILES 문자열 하나를 넣으면 제형 워크플로우가 시작됩니다
분자는 질문에 답하기 위해 실물 시료가 필요하지 않습니다. SMILES 문자열 — 분자 구조를 표현하는 표준화된 표기법 — 로 나타내면, 단 1밀리그램도 계량하기 전에 파싱하고 정규화해 예측 모델에 바로 넣을 수 있습니다.
저희 플랫폼은 제형 의사결정이 실제로 의존하는 물성들을 예측합니다. pH 구간별 용해도, 투과도, logP와 logD, pKa, 녹는점과 끓는점, 밀도, 생체이용률 같은 것들입니다. 하지만 예측은 도착지가 아닙니다. 제형을 선택하고, 실험을 계획하고, 결과를 평가하는 다음 세 단계로 이어지는 입력값입니다.
물성 프로파일에서 제형 후보로
부형제를 선택하는 일은 검색 문제이기 전에 추론 문제입니다. 용해도, 분배계수, 분자량은 누군가 참고표를 펼치기도 전에 그 물질이 무엇을 할 수 있는지 — 충진제인지, 결합제인지, 붕해제인지, 계면활성제인지 — 범위를 좁혀 줍니다.
저희 플랫폼은 예측된 물성 프로파일을 바탕으로 제형 후보를 직접 제안하고, 각 후보를 선례와 대조합니다. 비슷한 원료의약품이 실제로 어떻게 제형화되었는지 확인하는 것입니다. 정확히 일치하는 사례는 출발점으로 삼고, 정확하지 않은 사례는 정확하지 않다고 표시합니다. 조용히 정확한 것처럼 확장하지 않습니다.
실험을 하기 전에 실험을 설계합니다
제형 후보가 정해지면, 다음 질문은 테스트할지 말지가 아니라 몇 번을, 어떤 수준으로, 어떤 순서로 진행해야 가장 적은 시료로 가장 많이 배울 수 있는가입니다. 이는 통계적 설계 문제이지만, 지금은 대부분 연구원이 엑셀에서 손으로, 한 번에 하나의 요인씩 풀고 있습니다.
저희 플랫폼은 제형 변수 — 요인, 수준, 실행 순서 — 로부터 실험 설계를 직접 생성합니다. 그래서 벤치로 나가는 계획은 나중에 다시 정리할 필요 없이 이미 분석하기 좋은 형태로 짜여 있습니다.
“이거 다른 프로젝트에서 이미 해봤는데, 그 파일을 못 찾겠어요.”
“이 설계표, 지난번 것이 누군가의 노트북에 묻혀 있어서 또 손으로 만들었어요.”
“이 용량 표는 완전히 다른 약에 대한 건데.”
건너뛴 실험 하나가 곧 되찾은 한 주입니다
이전에는 부형제 적합성에 대한 가설을 확인할 방법이 하나뿐이었습니다. 직접 실험하고, 저장되지 않은 설계표를 다시 만드는 것까지 두 번 일해야 했습니다. 지금은 시료 하나를 준비하기 전에 같은 가설에 물성 기반 추정값과 생성된 실험 설계를 먼저 적용하고, 물리적 실험은 예측과 설계만으로는 판단할 수 없는 경우를 위해 남겨둡니다.
벤치 실험을 없애자는 이야기가 아닙니다. 정말 필요한 실험에 벤치 시간을 쓰고, 충분히 잘 설계해서 대개 한 번으로 끝내자는 것입니다.
하루가 걸리던 레퍼런스 조사
제형 결정은 물질 하나만으로 내려지는 경우가 드뭅니다. 선례에 의존합니다. 비슷한 원료의약품이 이전에 어떻게 다뤄졌는지, 비교 가능한 제형에 어떤 부형제가 쓰였는지, 특허나 논문이 핵심 품질 속성(CQA)에 대해 뭐라고 말하는지 같은 것들입니다. 보통 이는 형식도, 검색창도 공유하지 않는 특허와 논문과 사내 기록을 넘나들며 찾는다는 뜻입니다.
저희 플랫폼은 이 레퍼런스 데이터를 예측 결과와 같은 곳에서 구조화된 형태로 검색할 수 있게 유지합니다. 용해도에 대한 가설을 확인하는 것과 그 가설의 선례를 확인하는 것 사이에 도구를 바꿀 필요가 없습니다.
모든 것이 담긴 폴더 대신, 하나의 작업 공간
흩어진 문서의 진짜 비용은 저장 공간이 아닙니다. 다시 짜맞추는 일입니다. 한 프로젝트의 제형 결정, 실험 설계, 평가 결과가 각각 다른 파일에 흩어져 있을 때마다, 누군가는 "우리가 이 부분에서 어떤 결론을 냈고, 왜 그랬는지"라는 간단한 질문에 답하기 위해 그것들을 손으로 다시 이어 붙여야 합니다.
저희 플랫폼은 한 화합물의 물성 분석, 제형 설계, 실험 설계, 평가 결과 — 기준 표준과 비교한 내용까지 포함해서 — 를 처음 예측된 물성부터 마지막으로 측정된 값까지 하나의 연속된 기록으로 연결해 둡니다. 보고할 때가 되면 그 기록은 누군가 손으로 합쳐야 하는 파일 묶음이 아니라, 정리된 문서로 바로 내보내집니다.
알케는 이렇게 만듭니다
예측을 먼저 하고, 예측이라고 말합니다
플랫폼에 표시되는 모든 물성값은 있는 그대로 표시됩니다. 측정값이 아니라 추정값이라고요. 이 구분은 각주가 아닙니다. 예측이 존재하는 이유는 실험을 대체하는 척하기 위해서가 아니라, 다음 실험을 어디에 써야 할지 알려주기 위해서입니다.
설계와 근거를 같은 곳에 둡니다
실험 설계(DOE) 계획, 용출 비교, 제형 기록은 그것들을 만들어낸 물성 예측 및 레퍼런스 데이터와 나란히 존재합니다. 연구원이 기억에 의존해 따로 재구성해야 하는 별도 문서가 아닙니다.
다시 만든 엑셀 파일을 증상으로 봅니다
한 팀이 같은 비교표를 두 번 이상 만든다면, 그건 교육이 부족해서가 아닙니다. 플랫폼이 이미 그 답을 갖고 있었어야 한다는 신호입니다. 저희는 반복되는 엑셀 파일 하나하나를 그렇게 줄여가고 있습니다.
이 중 어떤 것도 제형 연구원의 판단을 대신하지 않고, 그럴 의도도 없습니다. 이것이 없애는 것은 예측하고, 설계하고, 테스트하는 각 단계 사이에서 치러야 했던 비용입니다. 예측이면 몇 초 만에 될 일을 다시 도출하는 데 쓴 한 주, 어딘가 이미 있었을 설계표를 처음부터 다시 그린 오후, 서로 맞지 않는 파일들을 이어 붙여 만든 보고서 같은 것들입니다. 알케는 이를, 예측을 완제품이 아니라 워크플로우의 첫 단계로 다룰 때 어떤 모습인지 보여주는 하나의 사례로 만들어가고 있습니다.